커널 자동 업데이트와 GPU 드라이버 — nvidia-device-plugin 장애 복구기
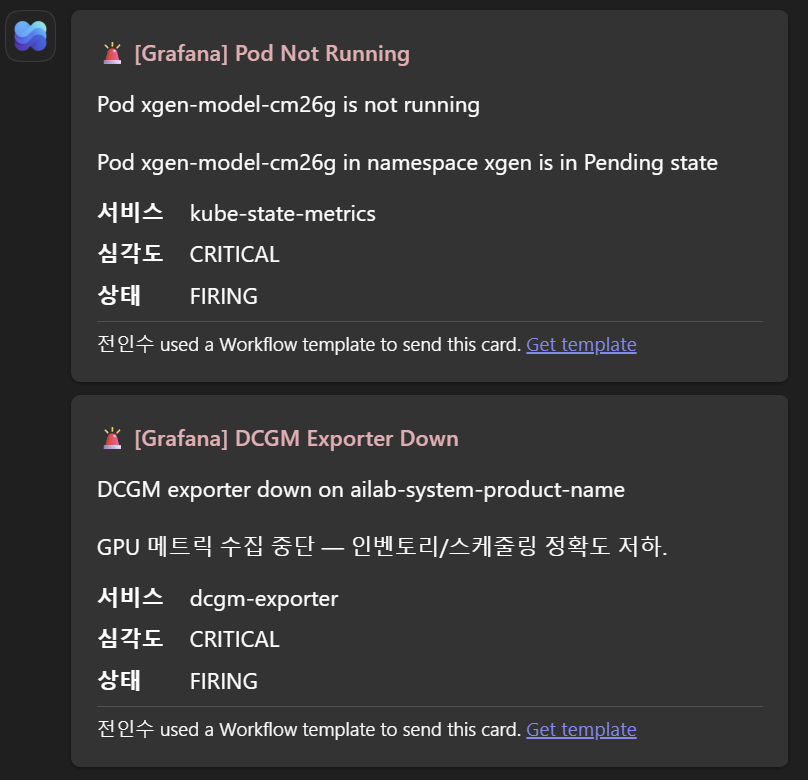
평소에는 크게 중요하지 않은 WARNING 알람이 오고 마는 Microsoft Teams 모니터링 채널에 왠일로 CRITICAL 알림이 두 개 날아왔다. 하나는 vLLM 서빙 파드가 Pending되었다는 경보였고, 나머지 하나는 GPU 메트릭 수집을 위한 DCGM exporter가 죽었다는 경보였다. 두 가지 경보 모두 서버 내 모델 서빙이 멈췄다는 걸 지시하는지라, 황급히 바로 서버 내부를 들여다봤다.
Warning  FailedScheduling  20m (x52 over 4h16m)  default-scheduler
0/1 nodes are available: 1 Insufficient nvidia.com/gpu. preemption: 0/1 nodes are available: 1 Insufficient nvidia.com/gpu.
kubectl describe po로 중단 원인을 확인해보니 GPU 리소스가 부족하다는 메시지가 떠 있었다. 노드가 하나뿐인 작은 클러스터지만, 이 노드에는 GPU가 두 장이나 꽂혀 있었다. 리소스가 부족할 이유가 없는데 이런 메시지가 뜬다는 것 자체가 이상했다.
그래서 다음으로 kube-system에 떠 있는 nvidia-device-plugin 데몬셋의 에러를 확인해봤다.
State:          Waiting
  Reason:       CrashLoopBackOff
Last State:     Terminated
  Reason:       StartError
  Message:      failed to create containerd task: failed to create shim task: OCI runtime create failed:
                could not apply required modification to OCI specification: error modifying OCI spec:
                failed to create the automatic CDI modifier: failed to generate CDI spec for mode "auto":
                failed to construct device spec generators: failed to initialize NVML: Driver Not Loaded
  Exit Code:    128
  Restart Count: 70
Driver Not Loaded. 호스트에 멀쩡히 설치해둔 NVIDIA 드라이버가 없다는 메시지였다. 분명 설치돼 있는데, 왜 없다고 하는 걸까. 아무래도 쿠버가 아니라 호스트에 문제가 있는 것 같아 트러블슈팅 위치를 호스트로 옮겼다. 이렇게 호스트로 위치를 옮기니 문제 원인을 금방 특정할 수 있었는데...
uname -r #7.0.0-34-generic

dpkg -l | grep -i nvidia | grep linux-modules-nvidia
# ii  linux-modules-nvidia-595-open-7.0.0-31-generic   7.0.0-31.31~24.04.1+1
# ii  linux-modules-nvidia-595-open-generic-hwe-24.04  7.0.0-31.31~24.04.1
# rc  linux-modules-nvidia-595-open-7.0.0-28-generic   ...
# rc  linux-modules-nvidia-595-open-7.0.0-29-generic   ...
# rc  linux-modules-nvidia-595-open-7.0.0-30-generic   ...
결과적으로 커널 버전과 드라이버 모듈 버전이 어긋나 있었다. uname -r로 커널 버전을 찍어보니 7.0.0-34였는데, 설치된 드라이버 모듈은 7.0.0-31까지만 지원했다. 원인은 알겠는데, 한편으론 여전히 이상했다. 멀쩡히 잘 돌아가던 게 왜 갑자기 이렇게 어긋나버렸을까. 그래서 확인해본 결과,
vi /etc/apt/apt.conf.d/20auto-upgrades
# APT::Periodic::Update-Package-Lists "1";
# APT::Periodic::Unattended-Upgrade "1";
이 서버에 패키지 자동 업데이트가 켜져 있었고, 이게 가장 근본적인 원인이었다. NVIDIA 드라이버는 dkms 방식이면 커널이 바뀔 때 그 자리에서 모듈을 재빌드한다고 한다. 그런데 이 서버는 그러한 방식이 아니며, Ubuntu가 커널 버전별로 미리 빌드해 배포하는 linux-modules-nvidia-595-open-<커널버전> 패키지 방식을 쓰고 있었다. 이 방식에서는 커널 버전에 대응하는 모듈 패키지가 따로 설치되어야만 드라이버가 동작하는데, 자동 업데이트는 커널만 올리고 드라이버는 챙기지 않았던 거다.
긴급 복구 방안은 간단하다. 커널 버전에 알맞게 NVIDIA 드라이버 모듈도 업그레이드하는 거다. 일단 저장소에 업그레이드된 커널용 모듈 패키지가 있는지 확인해봤고
sudo apt update
apt-cache policy linux-modules-nvidia-595-open-$(uname -r)

# linux-modules-nvidia-595-open-7.0.0-34-generic:
#  Installed: (none)
#  Candidate: 7.0.0-34.34~24.04.1+1
다행히 버전에 알맞는 패키지가 이미 저장소에 있는 걸 확인했다. 그래서
# NVIDIA 드라이버 모듈 설치
sudo apt install -y linux-modules-nvidia-595-open-7.0.0-34-generic

# 드라이버 재로드
sudo depmod -a
sudo modprobe nvidia
해당 모듈을 설치하고 드라이버를 다시 로드했다. 이후 nvidia-smi로 드라이버가 정상 동작하는 걸 확인했다. 그다음 nvidia-device-plugin 파드를 삭제해 재기동시켰고, 정상화되자 dcgm-exporter와 모델 파드도 함께 정상화됐다.
일단 여기까지 작업으로 급한 불은 껐고, 이러한 현상을 이대로 두면 십중팔구 재발할 것이기 때문에 재발 방지 방안을 어떻게 할지 조금 고민했다. 찾아보니 가장 이상적인 방안은 NVIDIA GPU Operator를 도입하여 드라이버를 호스트에 직접 설치하지 않으며, 컨테이너로 배포함으로서 커널 변경시 Operator가 자동으로 새 커널에 맞는 드라이버 컨테이너를 다시 빌드/로드하도록 만드는 것이었는데, 이는 현재 운영 중인 서버 대상으로는 아무래도 부담이 큰 작업이었다. 호스트에 설치된 NVIDIA 드라이버 패키지를 날리고 다시 설치해야 하기 때문이었다.
sudo vi /etc/apt/apt.conf.d/20auto-upgrades
# APT::Periodic::Update-Package-Lists "0";
# APT::Periodic::Download-Upgradeable-Packages "0";
# APT::Periodic::AutocleanInterval "0";
# APT::Periodic::Unattended-Upgrade "0";
그래서 현실적인 선택으로, 이 서버의 자동 업데이트를 꺼두기로 했다. 물론 보안 패치 등이 이뤄지지 않는 자잘한 문제 등이 있긴 하나, 트러블을 최소화하며 재발 방지하는 데는 최선의 선택이라 판단했다.